


移动通信网 程然
在日前举行的京东2026全球科技探索者大会上,京东云与国产GPU厂商摩尔线程宣布了一项重磅合作:双方将联手打造一个由10万块国产GPU组成的大规模算力集群。据京东云方面介绍,这是国内头部AI云服务商首个自主托管的该规模国产GPU集群,将全面采用中国本土硬件构建,面向大模型训练、推理以及具身智能等前沿工作负载。这一项目的落地,标志着国产算力基础设施从"可用"向"规模化可用"迈出了实质性一步。
从万卡到十万卡:合作规模的跨越式升级
此次并非双方的首次联手。公开信息显示,京东云与摩尔线程此前已经合作建成过一个万卡规模的GPU集群,并在实际业务中完成了技术验证。从1万卡到10万卡,规模的十倍跃升远非简单的硬件堆叠——大规模集群对互联带宽、并行计算框架、故障恢复机制以及能耗管理都提出了数量级更高的要求。能够将合作规模推向十万卡量级,也从侧面反映出双方在万卡阶段积累的工程经验已经趋于成熟。
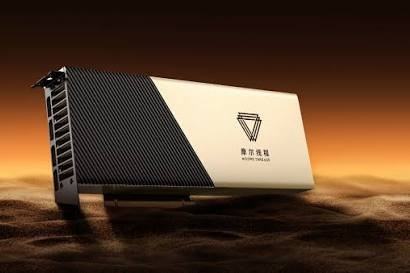
根据国内媒体报道,该集群将由摩尔线程的"全功能GPU"构成,具体产品型号官方尚未披露。不过从摩尔线程官网的产品线可以窥见其技术底气:其旗舰产品MTT S5000基于PH100芯片,采用自研的"平湖"架构,支持从FP8到FP64的全精度计算能力。全精度覆盖意味着这批GPU不仅能胜任对精度要求相对宽松的推理场景,也可以支撑科学计算和大模型训练中对数值精度有严格要求的任务。此外,该公司还拥有基于春晓芯片的MTT S3000以及S4000等产品,形成了从边缘到数据中心的梯度化布局。
【关键数据】
- 集群规模: 100,000卡国产GPU(国内头部AI云厂商首个该规模国产集群)
- 既有合作: 双方此前已建成10,000卡GPU集群
- 核心产品: MTT S5000(PH100芯片,平湖架构)
- 精度支持: FP8至FP64全精度计算
- 工作负载: 大模型训练、推理、具身智能
国产算力生态的"云芯片"协同样本
京东云作为京东集团旗下的云计算服务商,在国内拥有覆盖广泛的数据中心布局,核心节点分布于北京、广州、上海和宿迁四地。雄厚的自建基础设施,为十万卡集群的托管和运营提供了物理承载条件。对于京东云而言,接入大规模国产GPU算力,既是完善自身AI服务能力的技术选择,也是在当前供应链环境下增强算力自主可控程度的战略布局。
摩尔线程的背景同样值得关注。该公司由前英伟达全球副总裁张建中于2020年创立,投资方阵容包括深创投、纪源资本、红杉中国以及字节跳动、腾讯等产业资本,并已登陆上交所科创板。在资本与产业资源的双重加持下,摩尔线程近年来在国产GPU赛道中的存在感持续提升,与头部云厂商的深度绑定成为其区别于部分同行的竞争策略。
从行业视角看,此次合作的意义超越了两家公司本身。在外部算力供给受限的环境下,国产AI芯片能否获得真实的大规模训练场景验证,是决定其技术迭代速度的关键。十万卡集群恰恰提供了这样的"练兵场"——大规模并行场景中暴露的互联、调度、稳定性问题,将反向推动国产GPU软件栈和系统级方案的完善。云厂商出场景、芯片厂商出算力的"云芯协同"模式,正在成为国产算力生态演进的一条主线。
商业化考验:集群利用率是最终标尺
当然,集群建成只是第一步。十万卡规模意味着巨大的资本投入和电力消耗,后续能否吸引足够多的大模型训练和推理需求、保持集群的高利用率,将直接决定这一项目的商业可持续性。官方目前未披露集群的交付时间表、部署地点及具体服务对象,这些细节值得持续追踪。可以确定的是,随着此类超大规模国产算力项目的陆续落地,中国AI基础设施的国产化进程正在从政策驱动转向市场验证阶段,京东云与摩尔线程的这次联手,将成为观察国产GPU规模化商用成色的重要样本。
出处:JD Cloud and Moore Threads team up on cluster of 100,000 GPUs
英文原文


