


移动通信网 赵哲超
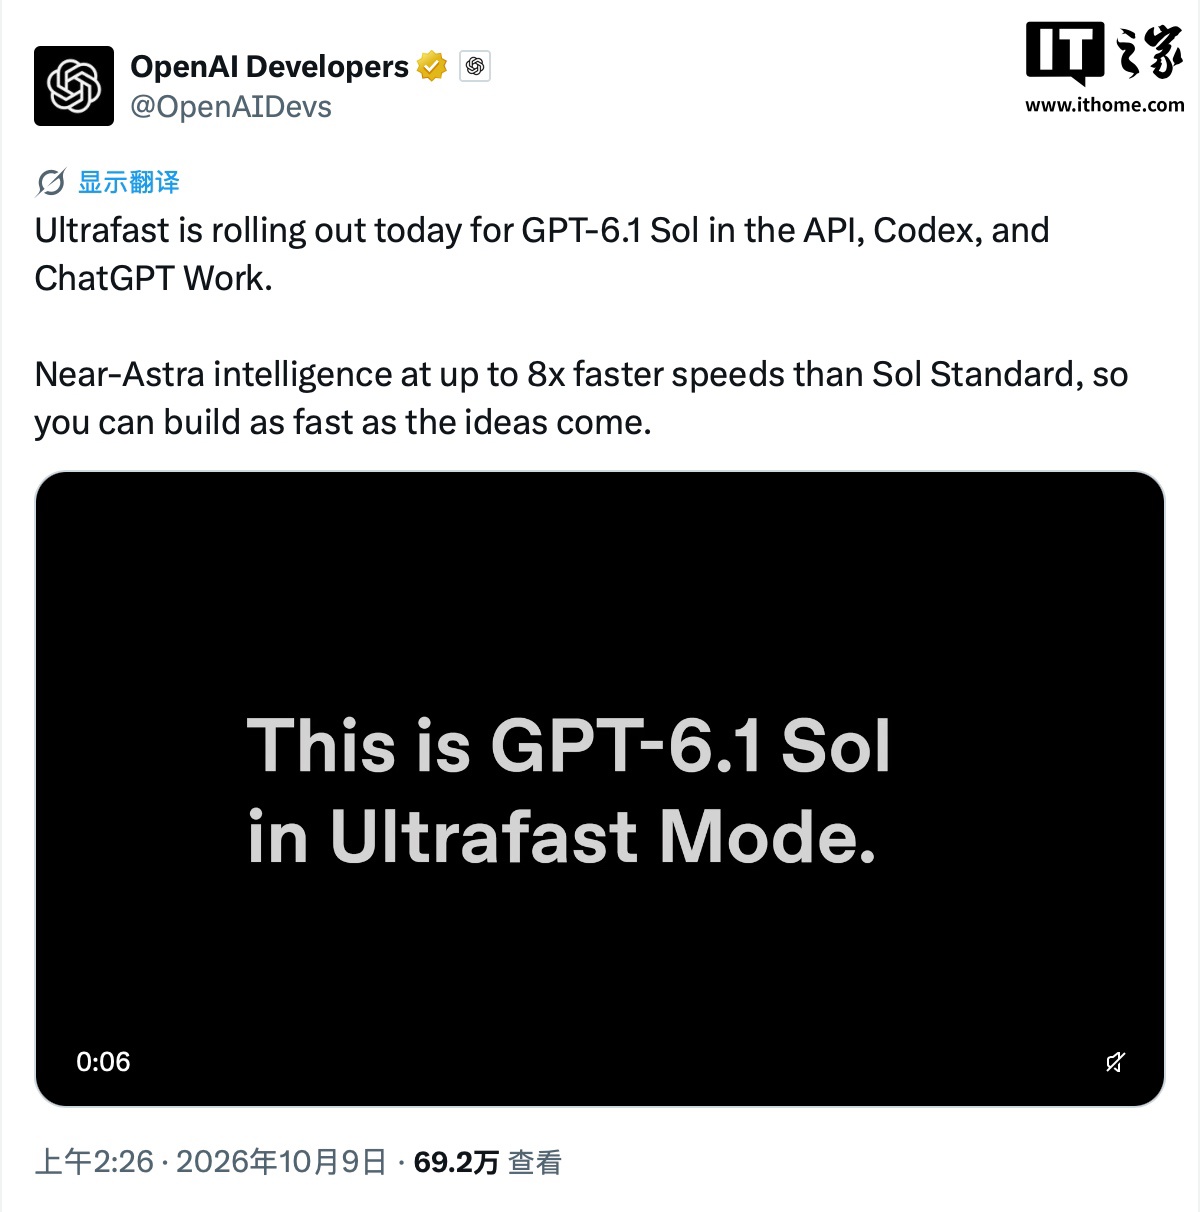
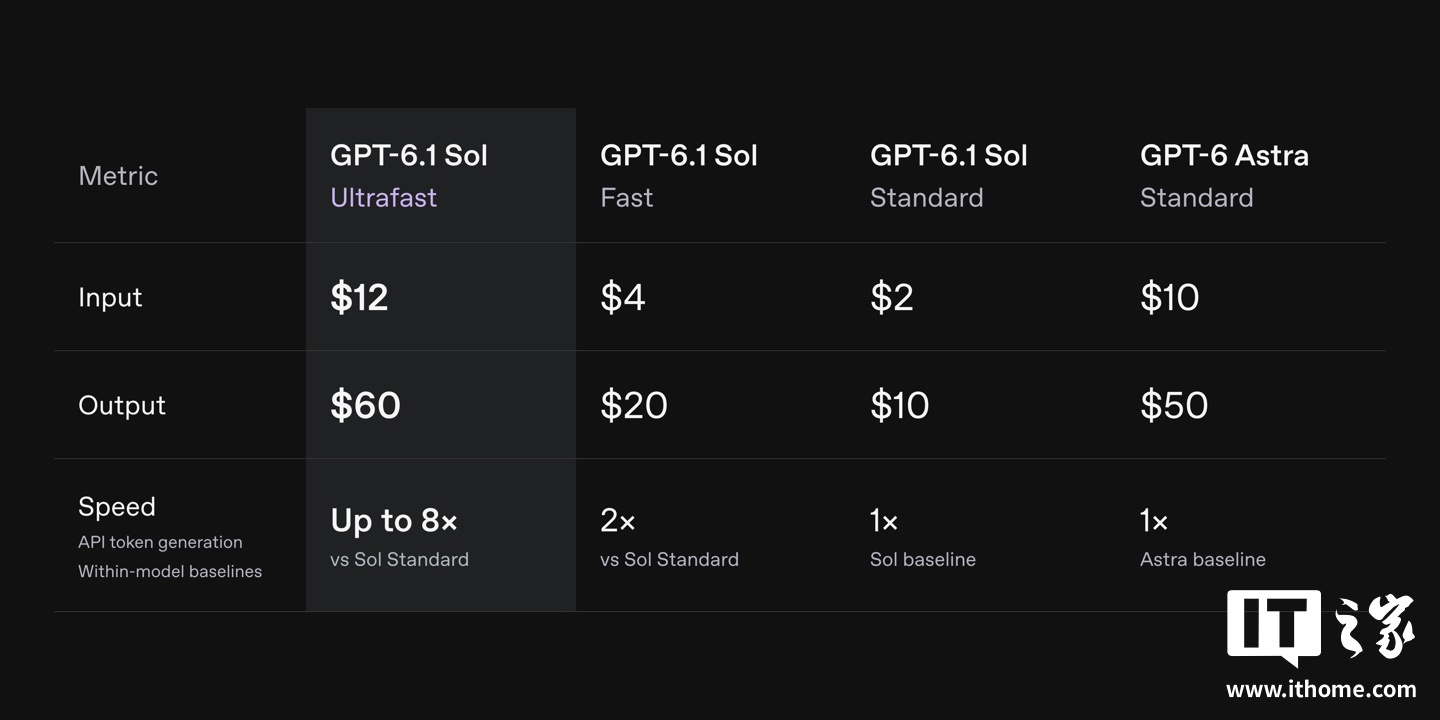
OpenAI Developers官方渠道确认,GPT-6.1 Sol的Ultrafast版本已正式登陆API、Codex和ChatGPT Work三大产品线。这一版本最核心的变化体现在两个数字上:推理速度最高达到Sol Standard标准版的8倍,而定价则是标准版的6倍——每百万tokens输入收费12美元(按当前汇率约合80.5元人民币),每百万tokens输出收费60美元(约合402.7元人民币)。对比标准版每百万tokens输入2美元、输出10美元的定价体系,Ultrafast版本将输出价格推高至60美元,已经逼近此前OpenAI旗舰推理模型o1-pro每百万tokens输出600美元的十分之一水平,但速度优势成为其核心卖点。从行业背景看,大模型API竞争已从单纯的参数规模竞争转向推理效率与响应延迟的竞争,Claude、Gemini等竞品均在压缩首token延迟(TTFT)上持续投入,OpenAI此次以“快”为刀切入市场,意图锁定对延迟敏感的企业级开发者群体。
【关键数据】
[1] 推理速度最高达Sol标准版的8倍
[2] 输入定价每百万tokens 12美元(约合80.5元人民币)
[3] 输出定价每百万tokens 60美元(约合402.7元人民币)
[4] 定价为标准版的6倍
[5] Pro 500订阅方案月费500美元档位
从技术层面分析,Ultrafast版本的实现路径大概率依赖推理侧的深度优化而非模型架构的根本性改变。业界通行的加速手段包括: speculative decoding(推测解码)、更激进的KV缓存策略、定制推理芯片利用率提升以及批处理调度优化。8倍的速度提升意味着原本需要40秒生成的长文本输出可压缩至5秒左右完成,对于代码补全、实时对话、Agent多轮调用等场景,这种量级的延迟改善会直接改变产品体验。定价6倍于标准版的溢价结构也透露出成本逻辑:高速推理通常意味着更低的GPU批处理密度、更高的算力冗余占用,OpenAI将这部分边际成本转嫁给付费方。值得注意的是,该版本在Codex编程助手中的落地尤为关键——代码生成场景对token输出速度的敏感度远高于普通聊天,每秒输出的tokens数(tok/s)直接决定开发者的采纳意愿,8倍速度在IDE实时补全场景中接近“即时响应”的体验阈值。
从市场格局看,大模型API高端定价带正在快速成形。OpenAI此次将输出价格定在每百万tokens 60美元,直接对标的是需要低延迟高吞吐的企业级负载。对比竞品:Anthropic的Claude Opus系列输出定价约为每百万tokens 75美元,Google Gemini 1.5 Pro输出定价为每百万tokens 21美元,Ultrafast以速度差异化在两者之间卡位。开放范围上,该功能目前面向Pro 500订阅方案、符合条件的按量付费Enterprise企业版以及采用配额计费的Edu教育版用户,企业用户需由管理员主动开启权限,这一权限管控设计延续了OpenAI面向企业的分级售卖策略。区域覆盖方面,Ultrafast版本已在所有支持区域上线,并全面支持美国和欧盟境内的数据驻留合规服务——数据驻留(Data Residency)是企业级采购的硬性合规门槛,欧盟GDPR框架下不少欧洲金融机构此前无法调用美区API,此项支持的补齐预计将打开一批此前受合规限制的欧洲客户。
产业链角度,推理加速服务的商业化对上游算力供应链提出新要求。高速推理意味着更高的单用户GPU占用率和更低的并发密度,OpenAI需要为Ultrafast流量预留更多H100/B200级别的算力资源,其与微软Azure、CoreWeave等算力供应商的采购协议压力将随之上升。从成本结构推算,假设标准版推理的GPU利用率通过大batch实现摊薄,Ultrafast模式下batch size可能压缩至原来的四分之一到八分之一,这解释了6倍定价与8倍速度之间看似“让利”的定价逻辑——速度溢价并未线性放大,OpenAI显然在以略低于成本增速的定价抢占高速推理心智。对下游而言,API成本上升6倍将迫使应用开发者重新核算单位经济模型:一个日均调用100万tokens输出、依赖标准版成本10美元的应用,切换Ultrafast后日均成本升至60美元,月度支出增加约1500美元,只有客单价足够高的B端产品才能消化这一增量。
商业化落地方面,Ultrafast的首批应用场景已明确圈定在Codex和ChatGPT Work两条产品线。Codex场景中,8倍生成速度可将原本30秒的代码模块生成压缩至4秒以内,配合Pro 500方案(月费500美元档位)的企业开发者群体,构成OpenAI在AI编程工具市场对抗GitHub Copilot、Cursor、Claude Code的关键武器——编程助手市场的竞争焦点已从代码质量转向响应速度与上下文长度的综合体验。ChatGPT Work场景中,高速响应对企业内部知识问答、文档处理、工作流自动化等高频交互场景的价值直接体现在员工使用时长与任务完成率上。权限管理设计上,企业版需管理员主动开启,这为IT部门提供了灰度试用与成本管控的缓冲空间,符合大型企业采购SaaS服务的典型部署节奏。从售卖节奏看,先开放高价值订阅档位、再逐步下沉的策略,与OpenAI此前GPT-4 Turbo、o1系列的功能发布路径一致。
从行业趋势看,推理速度正在成为大模型厂商的第二个定价轴。此前市场普遍以模型能力(参数规模、基准测试分数)作为定价锚点,Ultrafast的发布确立了“同一模型、多档速度、差异化定价”的产品范式,后续不排除OpenAI进一步细分出Intermediate等中间档位。竞争对手的应对预计将快速跟进:Google凭借TPU自研芯片在推理成本上具备结构性优势,Gemini系列已有条件推出类似加速档位;Anthropic则可能通过Amazon Inferentia与Trainium芯片组合压低高速推理的溢价空间。对开发者生态而言,6倍价格换8倍速度的交易是否成立,取决于应用场景的延迟弹性——实时交互类产品倾向买单,离线批处理场景则无切换动力,这将推动应用层出现“速度路由”架构:同一应用根据任务类型动态选择标准版或Ultrafast版。OpenAI在数据驻留合规、企业权限管控、多档定价三个维度同步补强,显示其企业级市场战略正从模型能力输出转向基础设施级服务能力输出。


