


移动通信网 云坪
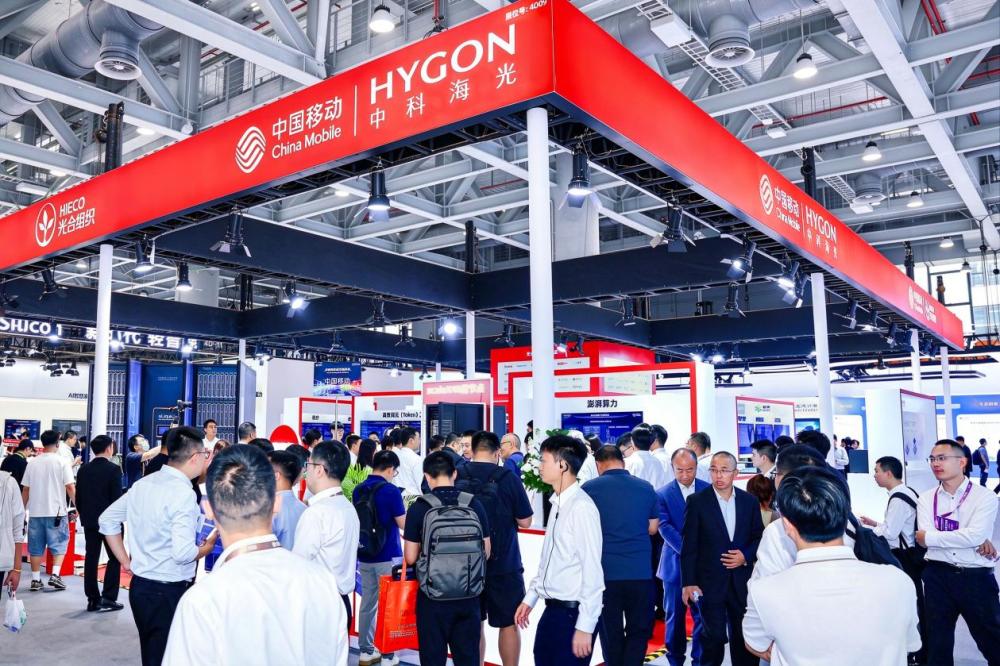
2026移动网络大会上周在广州举行,海光信息携CPU、DCU双芯架构集中亮相,覆盖端边计算、词元经营、可信算力三大方向,并获评“中国移动战略供应商”,同时作为成员单位参与共建“中国移动供应链风险预警中心”,与中国移动共同启动“MOMA生态开放计划”。大会期间,海光信息技术支持与中心通信行业方案部总经理王楠接受采访,从边缘侧1000系列芯片到多NUMA架构调度、PD分离工程瓶颈,再到运营商词元经营的吞吐、时延与成本,其核心指向一致:芯片侧要把“该谁干的活”分清楚。当前词元经营正成为算力产业价值兑现的主赛道,大模型加速向行业场景落地,端侧形成感知、推理、行动的业务闭环,边缘算力成为词元经营向产业末端延伸的关键支撑,而环境适配、供电散热、分散运维、生态碎片四大痛点亟待芯片层面的针对性方案。
【关键数据】
[1] 海光1000系列CPU典型TDP低至10W,4核8线程
[2] 支持-40℃至105℃宽温工作
[3] CPU核心数从32核向96核及以上演进
[4] PD分离架构下KV Cache跨节点传输为主要瓶颈
[5] 海光获评中国移动战略供应商并启动MOMA生态开放计划
端侧补位是海光此次展示的第一层逻辑。1000系列CPU采用C86架构,4核8线程设计,典型TDP低至10W,支持零下40摄氏度至105摄氏度宽温工作。王楠介绍,该系列主要面向低功耗场景,特点是低功耗、核心数少但性能强,适合宽温、工控以及室外恶劣环境部署。这颗芯片解决的不是峰值算力,而是在供电、散热、运维均不友好的生产现场长期稳定运行的能力,可支撑工厂设备控制、数据采集以及交通、能源、电力等领域的网关接入与现场计算,为词元经营补齐端侧生产场景。第二层逻辑在于双芯协同。随着产业发展,CPU核心数从32核向96核乃至更高演进,多NUMA架构成为常态,其收益是核心数量增长,代价是跨节点访问时延。海光开发NUMA亲和性技术,让内存数据直接亲和到离CPU核心最近的NUMA节点以提升整体效率,并将该思路延伸至CPU与加速卡之间,通过自动绑核让CPU最快到达GPU核心节点处理数据。
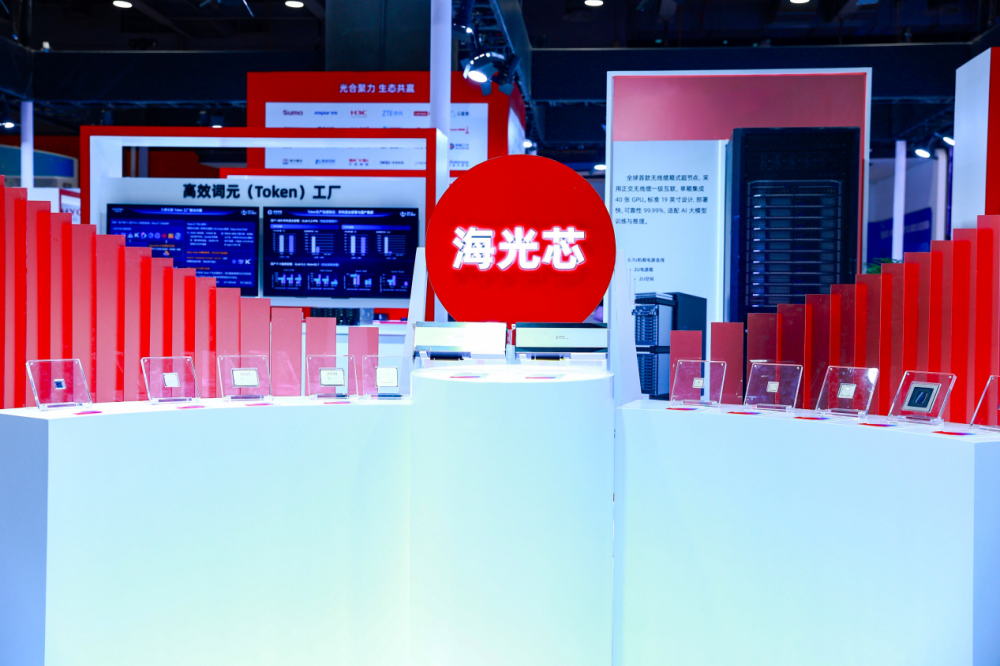
在推理环节,PD分离(预填充—解码分离)几乎是必选项,原因在于两个阶段对硬件需求截然不同:预填充阶段主要要求GPU具备强计算能力,解码阶段则要求大容量显存,需针对不同场景选择不同GPU型号。真正的瓶颈出现在P节点与D节点之间的数据传输上——KV Cache传输构成显著制约,海光通过优化跨节点数据传输路径与缓存管理机制提升传输效率,同时在CPU侧先完成数据预处理与调度,再进行内部处理。三步协同之下,CPU与DCU实现真正的联合工作而非各自为战。安全层面,海光将防护拆解为两层:第一层针对模型与数据本身,CPU、GPU均内置内生安全模块,保证数据可用不可见,在云化场景下租户只能看到自己的数据,其他宿主机无法窥视;第二层针对数据在芯片之间的搬运,此前CPU处理完的数据传输至GPU显存的通道采用明文,海光通过加密方式将其变为密文传输。王楠表示,CPU侧依靠CSV安全虚拟化与内存加密做底层防护,DCU侧配套安全处理与显存保护,两侧经安全通道连通,Token生成全过程纳入机密域保护。
从竞争格局看,国内AI芯片市场正处激烈卡位阶段。海光DCU采用GPGPU路线,兼容类CUDA生态,在运营商集采与金融、政务等行业市场持续放量。此次获评中国移动战略供应商,意味着其在运营商供应链中的地位进一步巩固,参与共建供应链风险预警中心则强化了双方的战略绑定。相比其他国产算力厂商,海光的差异化在于CPU+DCU双芯协同——多数厂商仅提供单一加速卡,异构调度需依赖第三方方案,而海光可从CPU调度中枢到DCU加速单元提供整体架构,在跨芯片算力统一调度和整体利用率提升上掌握主动权。词元经营作为运营商新赛道,其成本模型高度依赖单位Token的推理成本,即吞吐、时延与能耗三者的平衡,这恰恰是双芯架构的价值锚点:NUMA亲和降低时延、PD分离提升吞吐、10W级边缘芯片控制能耗,全链条服务于单位成本的下降。
产业链层面,海光的双芯策略对上下游均有拉动。上游方面,先进封装与HBM显存供应是DCU扩产的关键约束,KV Cache优化与缓存管理技术的价值在于缓解对显存容量的刚性依赖,降低BOM成本压力。下游方面,海光正与启明星辰等安全伙伴合作,利用DCU提升AI大模型安全模型的处理能力,芯片既是被保护对象,也是防护能力的放大器,这一双向定位打开了安全算力的增量市场。生态建设上,海光将依托光合生态,推动国产CPU、DCU及各类异构加速硬件的统一调度与协同运行,MOMA生态开放计划则为其提供运营商侧的落地入口。对于集成商与ISV而言,双芯统一调度架构降低了异构开发的适配成本,缩短行业解决方案的交付周期。
商业化进展方面,海光已在多个方向形成落地路径:1000系列面向工控、交通、能源、电力的网关接入与现场计算;DCU在智算中心承担大模型训练与推理负载;安全能力通过CSV虚拟化、内存加密与密文传输覆盖运营商词元经营全流程。中国移动的词元经营战略需要从中心云到边缘端的算力贯通,边缘侧恰恰是传统服务器芯片的短板地带,10W TDP加宽温设计填补了这一空档。从行业动向观察,国产算力厂商正从单点芯片竞争转向系统级架构竞争,谁能在调度、传输、安全三个维度同时给出答案,谁就能在运营商与行业客户的集采中获得溢价空间。海光此次展示的不只是两颗芯片,而是一条从端侧生产现场到中心智算、从算力调度到机密保护的完整链路,其后续在96核以上CPU与新一代DCU上的迭代节奏,将直接决定双芯架构的竞争纵深。




