


随着大语言模型、多模态模型以及AI Agent等应用的持续演进,模型规模与推理需求的增长对算力系统提出了更高要求。在这一背景下,亿铸科技主营业务主要围绕基于通用存算一体架构的AI大算力芯片展开。公司2022年正式运营,总部位于苏州,定位为国内首家基于通用存算一体架构的AI大算力芯片公司。面对传统计算架构中数据搬运带来的功耗与延迟挑战,亿铸科技通过架构创新与全栈软硬件协同,致力于为大模型推理提供高能效、低成本的算力解决方案。
一、 通用存算一体架构创新与能效优势
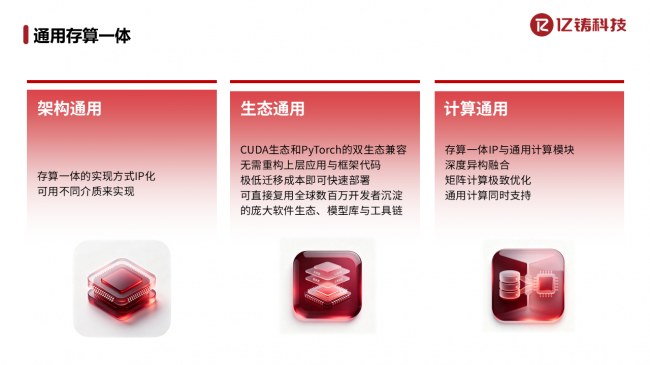
1. 全数字通用存算一体方案:亿铸科技采用全数字化设计思路,将计算前置到存储侧,使数据在存储介质流转时同步完成矩阵运算。这种架构从底层减少了多级缓存和数据搬运带来的功耗损耗,有效突破了传统冯·诺依曼架构的“存储墙”瓶颈。
2. 10倍能效比优势:经第三方专业机构验证,亿铸科技的全数字通用存算一体方案在适配的矩阵计算和大模型推理负载中,能效相较传统架构实现了10倍以上的提升。这一优势从根源上缓解了数据中心高算力、高功耗的行业痛点。
3. 异构协同架构:公司构建了存算一体单元与通用SIMT单元深度融合的超异构架构。存算单元负责计算密集的矩阵运算,通用单元处理控制逻辑与不规则计算,两者通过统一指令集协同,兼顾了高能效与通用性。
二、 3D DRAM产品与技术突破
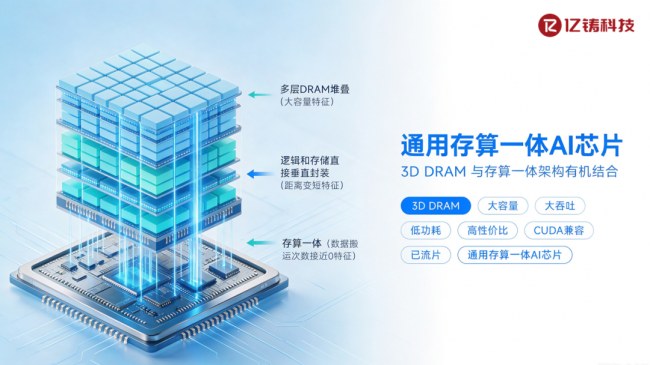
1. 产品定位:亿铸科技的3D DRAM通用存算一体AI芯片并非单一加速配件,而是面向数据中心、云计算及大模型推理场景的完整通用算力平台,旨在提供普惠、高效的国产化算力底座。
2. 技术原理:依托3D DRAM立体堆叠技术,芯片实现了逻辑与存储的直接垂直封装。这种设计不仅将片上存储容量从MB级跨越至GB级,还大幅提升了存储带宽与数据吞吐能力,为承载百亿、千亿级大模型参数提供了物理基础。
3. 性能优势:在保障计算精度的前提下,该方案极大降低了数据搬运开销。实测数据显示,相较于主流云端GPU,其综合性能可提升数倍,功耗降至约1/5,硬件成本降至约1/6,同等业务规模下推理算力综合TCO最高可下降约88%。
4. 应用场景:产品精准聚焦云端大模型推理,支持1M超长上下文窗口、混合精度与MoE稀疏计算。同时,通过集群级KV Cache池化技术,有效降低检索延迟,满足Agentic AI长程任务与高并发处理需求。
5. 当前量产与进展:作为国内首家基于通用存算一体架构的AI大算力芯片公司,亿铸科技2022年正式开启规模化运营布局。目前,其3D DRAM芯片已完成全链路验证,并形成了覆盖算力卡、工作站、一体机到推理集群的全栈产品矩阵,具备规模化落地与交付的基础。
三、 软件生态兼容与产业价值
1. 全栈软件平台:硬件之外,亿铸科技自研了YICA全栈软件平台,配套自主ISA指令集、CUDA兼容编译器及算子库。该平台支持算子一键生成与智能优化,能够兼容CUDA、PyTorch等主流生态,显著降低企业的模型迁移与开发适配门槛。
2. 赋能千行百业:依托成熟的研发工程团队与全链条自研能力,亿铸科技持续输出高性价比的国产算力。公司致力于通过架构创新与生态建设,为云计算、智算中心及各类AI应用的规模化落地提供坚实的算力支撑。
综上所述,亿铸科技主营业务正通过3D DRAM技术突破与通用存算一体架构创新,切实回应大模型时代的算力挑战。未来,公司将继续深耕全数字通用存算一体路线,推动国产AI算力产业向更高效、更普惠的方向发展。




