


移动通信网 程然
人工智能算力需求的膨胀速度正在逼近现有基础设施的物理极限。华为副董事长、轮值董事长汪涛9月17日在上海全联接大会2026上披露了一组对比数据:2020年大模型参数规模仅为1750亿,如今已迈向十万亿,预计2030年将突破百万亿,达到人脑神经元突触的数量级;中国每日推理Token消耗量已增至500万亿左右,2030年将进一步升至百万万亿级。需求陡峭上行,供给却遭遇双重约束——单芯片性能提升无法匹配需求增速,简单堆叠服务器的边际收益递减已成行业共识。汪涛给出的量化判断是:由8卡服务器组成的10万卡集群,芯片间通信代价超过所有训练时间的40%,业界10万卡集群的MFU(模型浮点算力利用率)往往不足30%,而MFU每提升1个百分点,十万亿级大模型的训练周期就能缩短约3天。将成千上万颗芯片“融”为一台计算机的超节点,由此成为破解之道。本次大会上,华为正式发布业界首个采用NPO(近封装光学)光引擎的超节点——昇腾960超节点,围绕“超节点+集群”构建中国算力底座的战略主线进一步清晰化。多家机构已将2026年称为“国产超节点方案元年”,7月19日鹏城实验室与全球计算联盟(GCC)联合38家单位发布《超节点定义与实践白皮书》,首次明确超节点“具备跨物理节点统一内存编址能力、逻辑上一台计算机”的系统定义,该定义已被高等教育出版社新版《人工智能导论》教材收录,共识沉淀至标准与学理层面。
【关键数据】
[1] 昇腾960超节点最大提供8E FP8算力、1PB HBM容量,可扩展至4096卡(单位:E FLOPS/PB/卡)
[2] Hi-ONE NPO光引擎单引擎传输容量7.2T,集成36个200G通道
[3] 昇腾960超节点以5500个Hi-ONE替代4.8万颗800G光模块,功耗降低超过550千瓦,可用度99.8%
[4] 4K规模超节点组成的10万卡集群MFU提升2.75倍,业界10万卡集群MFU普遍不足30%
[5] 昇腾910C超节点部署超1000套、客户超370家;昇腾950实现1024卡互联、256TB统一内存、3微秒时延
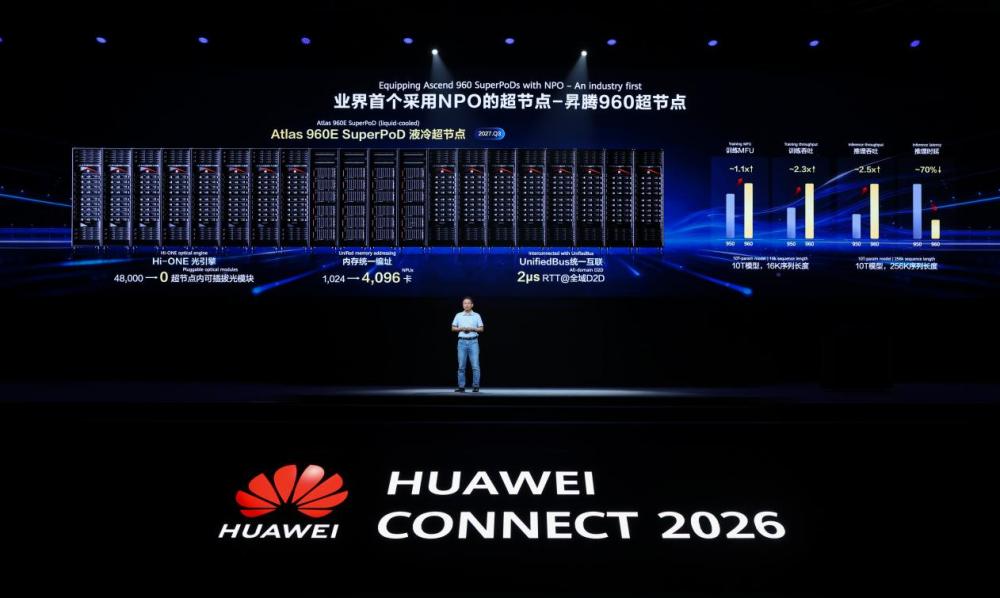
超节点的技术本质是重构互联架构。主流MoE模型训练涉及数万颗芯片和数百万亿次通信来对齐每一层计算的中间结果,传统集群中服务器之间的通信相比服务器内部会出现数量级时延跳变,一次通信从百纳秒级变成几十微秒。华为超节点以一套协议平等连接所有组件,支持跨物理节点统一内存编址,采用光互联使数万颗芯片间通信具备近乎线性的带宽与时延。华为马尔科夫实验室仿真数据显示,4K规模超节点组成的10万卡集群,相比8卡服务器组成的同等规模集群,MFU提升达2.75倍,且超节点规模越大收益越明显。本次互联层面的核心突破在于NPO光引擎:当SerDes速率达到224G及以上时,铜缆损耗与布线难度急剧上升,传统可插拔光模块难以满足扇出密度要求,把光引到计算芯片边缘成为必由之路。华为推出的业界首个量产NPO光引擎Hi-ONE将36个200G通道集成于一个模块,单引擎传输容量7.2T,是目前行业传输能力最大的NPO产品,也是唯一实现内置光源的NPO产品。汪涛详细解释了选择NPO而非CPO的技术逻辑:CPO将光电器件集中封装,但光器件和电芯片在材料体系、热与力的敏感度上差异巨大,共封装带来可靠性、可制造性和可维护性的一系列问题;NPO既实现光信号和电信号近距离“握手”,又保留光引擎独立性,最大程度延续客户使用习惯和产业生态。标准层面,5月21日由中国信通院联合华为、腾讯、阿里云等牵头提交的《12.8Tb/s光电近封装模块》标准提案,已在OIF 2026年二季度技术委员会正式立项。

系统层面,昇腾960超节点采用正交架构和全液冷设计,基于灵衢(UnifiedBus)协议实现内存统一编址,可扩展至4096卡规模,最大提供8E FP8算力与高达1PB的HBM容量,风冷和液冷版本分别于2027年第二季度、第三季度上市。核心计算芯片的性能同样倍增:昇腾960芯片提供2 PFLOPS FP8、4 PFLOPS FP4算力,片上HBM容量最大可达288GB,访存带宽9.6TB/s,2027年第一季度准备就绪,比原定目标提前三个季度;昇腾960PR支持2 PFLOPS FP8、8 PFLOPS FP4算力,2027年第三季度就绪,较原计划提前一个季度。在竞争格局中,昇腾超节点是目前国内唯一规模商用、也是唯一训练出SOTA模型的超节点:昇腾910C超节点已部署超过1000套,客户超过370家;昇腾950超节点已迈入规模商用阶段,实现1024卡NPU高速互联、256TB全局统一内存编址空间、TB级互联带宽与3微秒超低时延。7月世界人工智能大会上昇腾950真机亮相后,各大厂商纷纷跟进,国产超节点呈现“集团冲锋”态势。汪涛同时划定了真假超节点的分水岭:任何一颗AI芯片都能访问超节点内共享内存池,“内存不能统一编址的,不是超节点”。
产业链角度看,华为围绕灵衢协议打造了覆盖计算、互联、存储、管理的11颗关键芯片,包括承担核心计算的鲲鹏CPU与昇腾NPU、Scale-out平面大容量交换芯片、Scale-up平面低时延交换芯片、高速光互联芯片,以及面向AI KV缓存专门打造的Smart Storage Unit,实现平等一跳直达的缓存系统。去年全联接大会上,华为已全面开放灵衢协议技术规范,为上下游厂商接入超节点生态铺平道路。NPO光引擎对产业链的价值在系统成本结构上体现得尤为直观:昇腾960超节点以5500个Hi-ONE替代原本需要的4.8万颗800G光模块,功耗降低超过550千瓦,系统无故障运行时间提升一倍,可用度达到99.8%。光模块用量削减近九成,直接改变了超大规模AI集群中光器件的成本占比结构,同时全液冷设计与更高集成度降低了数据中心供电与散热压力。汪涛强调华为AI战略的核心是算力,坚持硬件变现,围绕“超节点+集群”构建竞争力——这一路径意味着互联芯片、光器件、液冷等配套产业链环节将随超节点规模化落地获得持续增量。
商业化进展方面,昇腾超节点已形成清晰的迭代节奏与客户基础。昇腾910C超节点超过1000套的部署量和370余家客户构成基本盘;昇腾950超节点以1024卡规模进入规模商用,支撑当前万亿级MoE模型的训练需求;昇腾960超节点则瞄准2027年十万亿参数级SOTA模型训练的标配——10万卡集群。应用场景上,智能体的能力演进勾勒出算力需求的下一曲线:2024年智能体还只能执行分钟级任务,今天已可按小时连续工作,到2030年将以“月”为单位执行任务,成为能独立承担复杂任务的数字员工。这意味着推理侧的Token消耗将从当前每日500万亿向2030年的百万万亿级攀升,推理基础设施对高利用率、低时延互联的依赖将进一步加深。华为马尔科夫实验室的仿真结论——超节点规模越大、MFU收益越明显——与4K规模超节点MFU提升2.75倍的数据,共同指向超节点在训练与推理一体化场景中的规模化落地逻辑。风冷与液冷双版本的推出,也为不同数据中心条件的客户提供了部署弹性。
行业走向层面,算力竞争已从单芯片跑分转向架构与系统综合能力的比拼。英伟达以NVLink+NVL机柜级方案主导国际市场,华为则以灵衢协议加超节点路线构建对位竞争力,并在协议开放、标准立项、白皮书定义三个层面同步推进生态建设:《12.8Tb/s光电近封装模块》OIF立项将中国方案带入国际标准组织,《超节点定义与实践白皮书》38家联合发布单位的阵容覆盖产学研,灵衢协议的全面开放降低了第三方厂商接入门槛。芯片研发进度的超预期——昇腾960提前三个季度、960PR提前一个季度——反映出供应链与研发体系的实际产出能力。对下游而言,MFU每提升1个百分点缩短约3天训练周期的杠杆效应,将直接改变十万亿参数模型竞赛的时间成本结构;对上游而言,NPO替代传统可插拔光模块的技术迁移已在系统设计中成为现实,4.8万颗800G光模块被5500个Hi-ONE替代的案例,为光器件厂商指明了下一代产品形态方向。超节点从概念争议走向规模商用的两年间,算力基础设施的竞争维度已被重新定义。


