


移动通信网 林知远
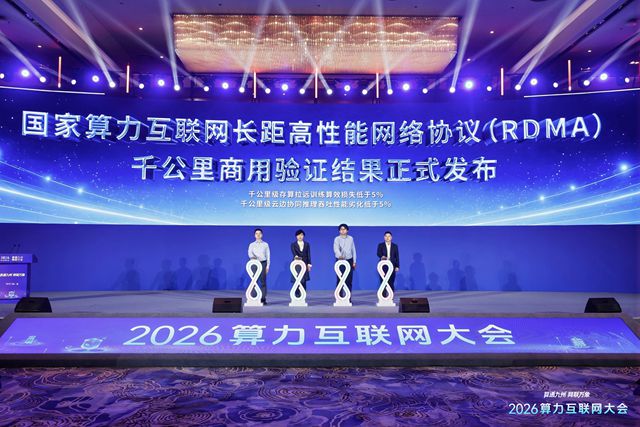
11月18日,2026算力互联网大会在武汉举办,本次大会由湖北省经济和信息化厅、湖北省通信管理局、武汉市人民政府、武汉东湖新技术开发区管委会联合主办。会议现场,中国信息通信研究院、中远海运科技股份有限公司、中国电信上海公司、华为技术有限公司四方联合发布国家算力互联网长距高性能网络协议(RDMA)千公里商用验证结果。验证数据显示,千公里级存算拉远训练场景下算效损失低于5%,云边协同推理场景下吞吐性能劣化同样控制在5%以内,这意味着在千公里之外调用远端算力资源时,业务性能已接近本地集群水平。随着大模型参数规模从千亿级向万亿级演进,单机柜、单数据中心已难以承载完整的训练与推理任务,分布式训推成为行业主流技术路线。然而传统广域网络在无损传输、低时延、零丢包等指标上长期无法满足RDMA协议的严苛要求,跨地域算力调度因此成为制约全国一体化算力网建设的核心瓶颈。此次商用验证结果的发布,直接回应了长距算力调用效率大幅折损、难以商用的行业痛点,为国家算力互联网跨域互联互通扫清了关键障碍。
【关键数据】
[1] 千公里级存算拉远训练算效损失低于5%
[2] 云边协同推理吞吐性能劣化低于5%
[3] 传统网络1%丢包率可导致RDMA吞吐性能下降50%以上
[4] 4家单位联合验证(中国信通院、中远海科、上海电信、华为)
[5] 验证结果于2026算力互联网大会(11月18日,武汉)正式发布
RDMA(Remote Direct Memory Access,远程直接内存访问)技术的核心价值在于绕过操作系统内核协议栈,让网络适配器直接读写远端服务器内存,从而将传统TCP/IP网络中数毫秒级的处理时延压缩至微秒量级,同时大幅降低CPU占用。在数据中心内部局域网环境中,RDMA已通过InfiniBand和RoCE(RDMA over Converged Ethernet)两种技术路线大规模商用,支撑着主流大模型训练集群的GPU间高速互联。但将RDMA能力延伸至千公里级广域网时,技术难度呈指数级上升:长距离光纤传输引入的物理时延、跨域网络设备的缓存深度限制、广域链路的流量突发与拥塞,都会导致RDMA在丢包后进入重传与降速的恶性循环——实验数据表明,传统网络上1%的丢包率就可能使RDMA吞吐性能下降50%以上。此次联合团队突破的关键技术包括长距无损RDMA传输与精准流量调度两大方向,通过端网协同的拥塞控制算法、动态速率调整机制以及跨域流量工程调度,在千公里传输距离上实现了零丢包的无损通道,最终将存算拉远训练的算效损失与云边协同推理的吞吐劣化双双压至5%以内,达到可商用的门槛。
从产业格局看,此次验证结果的分量可以从三个维度衡量。其一是参与主体的级别:中国信通院代表国家级科研机构的标准与技术验证能力,上海电信提供覆盖千公里跨域的运营商级骨干网络资源,中远海科贡献了大型央企的真实业务场景需求,华为则输出底层网络设备与协议栈技术,四方组合覆盖了从标准、网络、芯片设备到应用的全链条。其二是市场空间的规模:大模型训推基础设施投资持续攀升,国内智能算力规模近年保持高速增长,跨区域算力调度需求随之水涨船高,国家层面推进的“东数西算”工程与全国一体化算力网建设,都要求算力能够在枢纽节点之间高效流动,长距RDMA正是实现这一目标的关键使能技术。其三是竞争格局的变化:此前业界普遍认为广域网环境下RDMA性能折损不可避免,微软Azure、AWS等国际云厂商的跨区域高速互联方案主要依赖私有架构与就近部署策略规避距离问题,而此次国内团队选择正面攻克长距无损传输难题,走出了一条技术路径差异化的路线,为后续相关标准制定争取了主动权。
产业链层面,长距RDMA的商用化将带动上下游多个环节的价值重估。上游看,无损网络对交换机芯片的缓存容量、调度芯片的算力、光模块的传输性能提出了更高要求,支持智能无损特性的数据中心级交换机、400G及以上速率相干光模块、支持RDMA协议卸载的智能网卡(DPU)将迎来增量需求。中游看,运营商骨干网需要升级流量调度系统与网络控制器,实现跨域路径的毫秒级感知与动态调整,这直接关系到上海电信等参与方在网络运营侧的投入产出。下游看,算力使用成本结构将发生实质变化:以往企业为保障训推性能,必须将数据迁移至算力所在地,产生高昂的传输与存储成本,且本地算力不足时只能排队等待;长距RDMA成熟后,“数据不动、算力流动”成为可能,跨域调用远端算力的边际成本大幅下降,算力租赁市场的资源利用率有望显著提升。中远海科作为航运科技企业参与验证,也暗示了工业、交通等传统行业借助跨域算力加速自身数字化业务的潜在空间,算力消费方将从互联网与AI公司向更广泛的实体经济延伸。
商业化落地方面,此次发布的是“商用验证结果”而非实验室成果,两者的区别在于验证环境直接采用了运营商现网与真实业务负载。从应用场景看,最直接受益的是大模型分布式训练的存算拉远架构——训练集群部署在西部低成本电力枢纽,而数据预处理与热数据存储保留在东部业务集中区域,千公里距离上的算效损失控制在5%以内,使得这一此前仅存在于论文中的架构具备了工程可行性。云边协同推理场景同样意义明确:大模型推理需要将模型权重分发至边缘节点,广域链路的吞吐劣化此前是主要瓶颈,5%以内的劣化指标意味着边缘节点的用户体验与中心云基本拉平。从参与方的表态看,四方联合团队强调这一成果将为跨域算力资源高效协同、大模型分布式训推构筑“高速、安全、弹性”的高质量网络底座,措辞中“安全”与“弹性”指向的正是商用网络必备的可保障服务质量与故障自愈能力,表明相关技术已从单点性能验证进入体系化能力构建阶段。
从行业趋势看,此次成果发布的时间节点与算力网建设的政策节奏高度吻合。全国一体化算力网要求算力枢纽节点之间实现互联互通、资源统一调度,而跨域网络性能正是决定调度效率的天花板——网络层每降低一个百分点的性能损失,就意味着跨域算力协同在成本上更接近本地部署一分。可以预见的后续动向包括:其一,中国信通院可能基于此次验证结果推动长距RDMA相关的行业标准或测试规范落地,为更多网络设备厂商、运营商提供可执行的的技术基线;其二,上海电信的跨域组网经验有望向其他省级电信公司复制,扩大验证覆盖的地理范围与业务类型;其三,华为等设备厂商可以将验证中打磨的拥塞控制与流量调度能力固化为产品特性,加速向金融、汽车、生物医药等高算力消耗行业输出。对整个算力产业而言,当千公里不再是算力调度的红线,算力资源的定价与流转逻辑将被改写,算力真正成为一种可跨区域交易的基础资源,这一变化的深度将随着接入节点数量与业务规模的扩张持续显现。




