


移动通信网 赵哲超
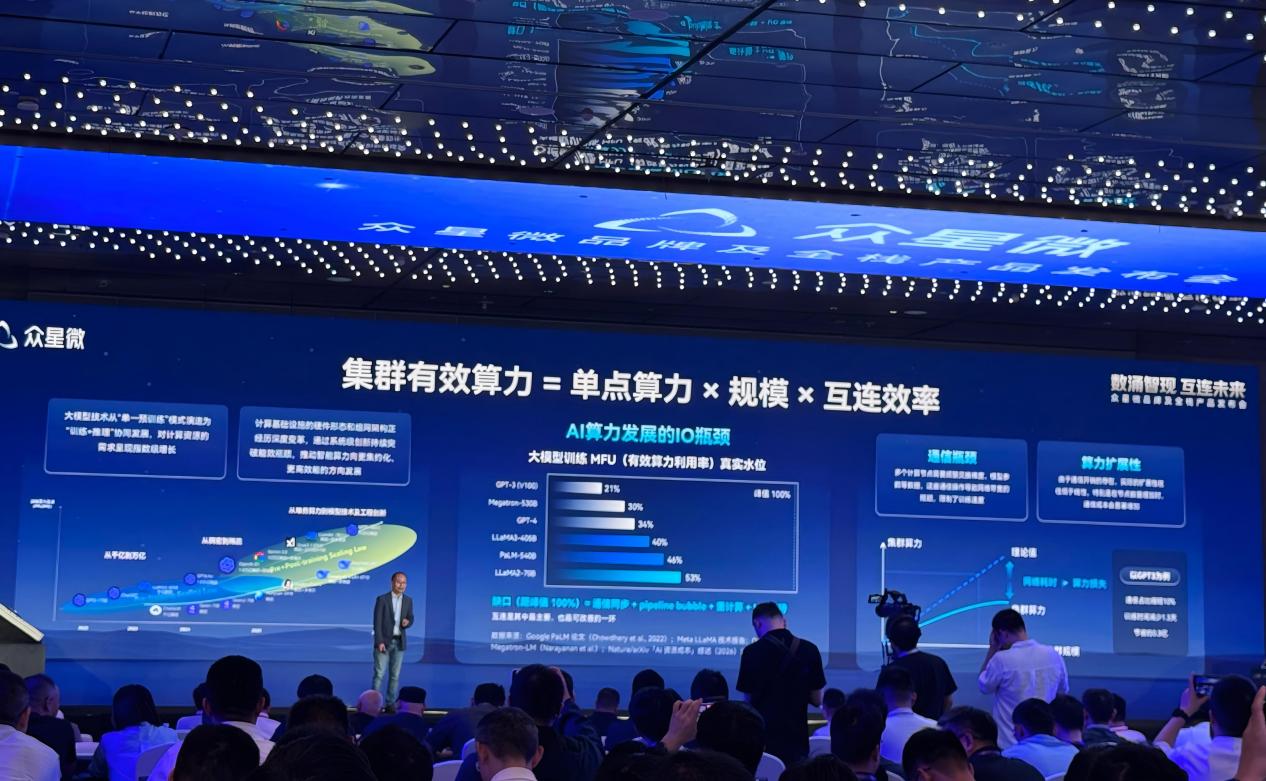
在国内算力基建高速扩张、资金大量涌向GPU与HBM的当口,一个被长期低估的问题浮出水面:重金堆砌的AI集群,实际运行效率远低于账面算力。被称为“中国博通”的无锡众星微系统技术有限公司近日举办品牌及全栈产品发布会,一次性公布12款量产产品及系列核心IP,并推出PCIe 6.0 Switch、800G多协议AI NIC、多模RAID芯片三大新品。众星微总经理郭二辉在主旨演讲中给出直击痛点的判断:大量大模型集群的算力并未投入模型运算,而是消耗在数据传输与等待环节。众星微副总经理兼总工程师宁佐林随后披露的行业现状更为严峻——整个集群真正释放出来的算力,大部分不超过50%,表现较好的也仅能达到60%至70%。公司成立于2020年,从2022年8月首批仅280颗出货起步,截至本次发布会累计出货已突破80万颗,预计2026年底出货有望突破100万颗,是国内高速互连赛道自主化的典型样本。
【关键数据】
[1] 累计出货量超过80万颗(截至发布会,2026年底预计突破100万颗)
[2] 国内高速互连芯片市场规模达千亿级别,互连芯片占超级节点硬件价值8%-9%
[3] AI集群实际算力释放率大部分不超过50%,较好水平为60%-70%
[4] 800G AI NIC集成PCIe Gen6 Switch 48 Lane,带宽较400G翻倍
[5] 6款芯片约20万颗产品支撑国内首个全国产十万卡AI集群,建设周期缩短至少1个月
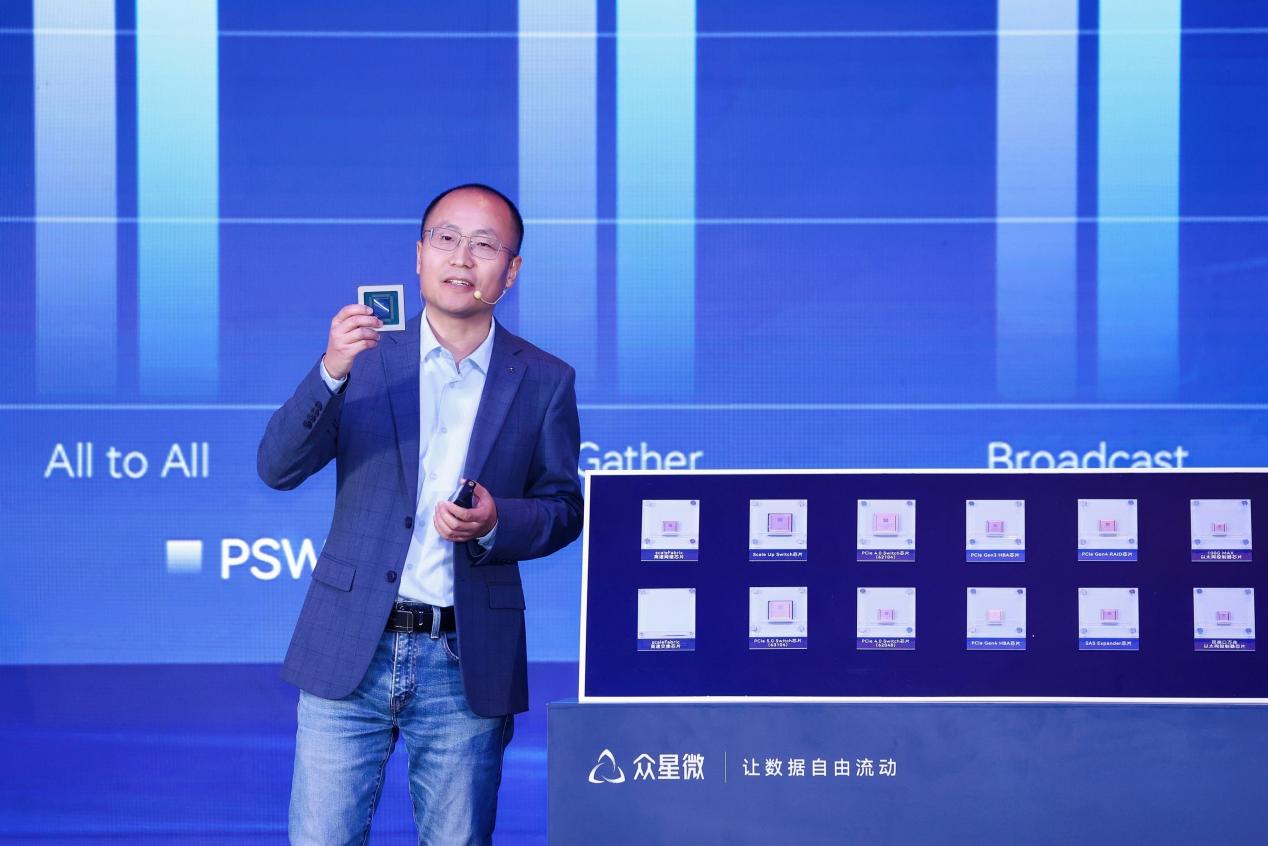
从技术逻辑看,众星微提出的解题公式是“集群有效算力=单点算力×规模×互连效率”,互连不再是配角,而是决定系统成败的关键乘数。宁佐林用一个“乘法逻辑”解释痛点的放大效应:集群中每个节点损失1%的效率,在万卡、十万卡规模下并非简单相加,而是持续连乘。算力系统从芯片内部的Die-to-Die,到超节点内的Scale-Up,再到跨节点的Scale-Out、跨域的Scale-Across,任何环节的数据拥堵都会导致算力闲置。在新品中,国内首颗800G多协议AI NIC标志着国产网卡跨入800G时代,其迭代包含三大变化:带宽较400G实现翻倍;面向新一代AI集群架构完成深度定制开发;可集成PCIe Gen6 Switch 48 Lane。芯片中硬化了拥塞控制、多路径、选择性重传等原本依赖软件处理的能力,集成设计可省去一颗独立交换芯片、优化链路插损、降低端到端时延,是国内唯一落地该集成方案的800G多协议AI网卡。
从市场规模看,郭二辉测算,在GB300、VR200两代超级节点架构中,互连芯片在整套节点硬件价值中的占比达到8%至9%,且伴随集群规模扩张,价值占比仍呈上行趋势,国内高速互连芯片市场已迈入千亿级别。与国内多为单品类产品型的互连芯片厂商不同,众星微以全场景高性能互连芯片平台为定位,产品矩阵覆盖存储互连(HBA/RAID/SAS Expander)、网络互连(高性能网卡、交换芯片)和AI互连(PCIe Switch、Scale-Up Switch等)三大领域。郭二辉介绍了全栈布局的两大优势:一方面存储互连、PCIe交换、高速网络等全系列产品自研并原生完成内部适配,可大幅缩短用户整机系统的联调与部署周期;另一方面系统出现故障时,单一供应商可以统筹定位,规避多厂商之间权责界定不清、底层技术难以协同排障的痛点。这种“一站式”能力正是博通在全球互连市场确立霸主地位的核心逻辑,也是国产替代进程中对标国际巨头的必经路径。
从产业链视角看,众星微六年发展史勾勒出国产互连芯片从0到规模化落地的完整路径。公司创立之初面临无成熟高端互连芯片研发经验、无完整团队、无成熟代码、无可用IP的“四无”困境。2021年末,存储IO芯片、PCIe4.0交换芯片回片并一次性点亮,填补国内相关领域空白;2022年8月首款产品正式出货,首批仅280颗;2024年累计出货突破10万颗,获评国家级专精特新“小巨人”;2025年累计出货量达40万颗;截至本次发布会累计出货超过80万颗。上游环节,公司自研高速SerDes IP,可同时适配电互连与光互连场景;产业链层面采用多元合作模式,在驱动器、解调器、光芯片、电芯片等环节联动量产伙伴与科研机构。宁佐林厘清业务边界:电芯片是核心自研方向,其余组件联合产业链伙伴协同开发,公司不谋求一家独大。下一代工程挑战同样明确——下一代交换芯片功耗可达2kW,接近家用电磁炉功率水平,散热与封装是必须攻克的关卡。
商业化落地层面,众星微已有6款芯片、合计约20万颗产品,支撑国内首个全国产十万卡AI集群落地,项目建设周期相对进口方案缩短至少一个月。在行业渗透上,公司已在金融领域积累近百家用户案例。众星微副总经理兼产品市场部总经理于颢指出,不同行业用户的核心诉求差异显著:运营商对功耗指标极其敏感,功耗直接决定长期算力运营成本;金融行业高度重视数据可靠性与完备验证案例;互联网企业则更关注互连芯片与存算分离、存算一体等创新架构的协同能力。国产互连芯片的规模化商用并非简单的参数对标,而是一场持续的“信任积累战”,需要搭建“落地案例—用户信任—规模放量”的正向循环,这要求厂商具备场景化定制能力,在各行业逐步完成替代渗透。于颢同时强调,兼容性是另一核心关卡——开源生态体系起源于海外社区,大量应用软件原生适配国外操作系统,需要国内芯片、整机、操作系统、软件全产业链协同共建国产软硬件生态。
从行业趋势看,算力竞赛的上半场追逐单芯片算力峰值,下半场的衡量标尺转向有效算力,最终体现在大模型Token吞吐能力与单位Token成本。光互连被视作下一代高速互连的核心方向,赛道热度高涨、大量企业扎堆涌入,但众星微坚持划定技术边界、踩着产业节奏推进:112G速率方案已在单机柜场景实现商用,224G方案持续迭代,448G产品将跟随产业节奏、待市场需求放量后推进量产。于颢对中长期架构创新保持乐观,他指出在Scale-Up、资源池化等下一代算力架构创新上,中美两国处于同一起跑线,两国都涌现出大量创新企业。郭二辉则给出了更宏大的产业愿景:相信在新的算力周期,国产互连可以支撑国内算力产业,未来也能助力国产大模型Token服务出海,形成全球竞争力。当千亿级互连市场迎来价值重估,“互连即效能”正在从产业口号变为真金白银的市场判断,国产互连的长跑才刚刚进入中程。




